02 / 07 · Estudo de casoSaaS de IA
Alertas que mostram aos CSMs quais contas precisam de atenção.
Ajudando CSMs a decidir quais contas precisam de atenção
Desenhei o Account Flagging, o primeiro módulo do Companion, a plataforma da Sciene. Nossa primeira versão mostrava todos os alertas que o sistema encontrava, e os CSMs ignoravam dois terços deles. A v1 mostra menos alertas e explica por que cada um disparou.
- 34% → 82% dos alertas reconhecidos em até 24 horas, depois que a v1 entrou no ar
- −75% no tempo para montar a lista de prioridades da manhã (medido antes e depois, com os mesmos CSMs)
- 92% de adoção diária entre 250 CSMs
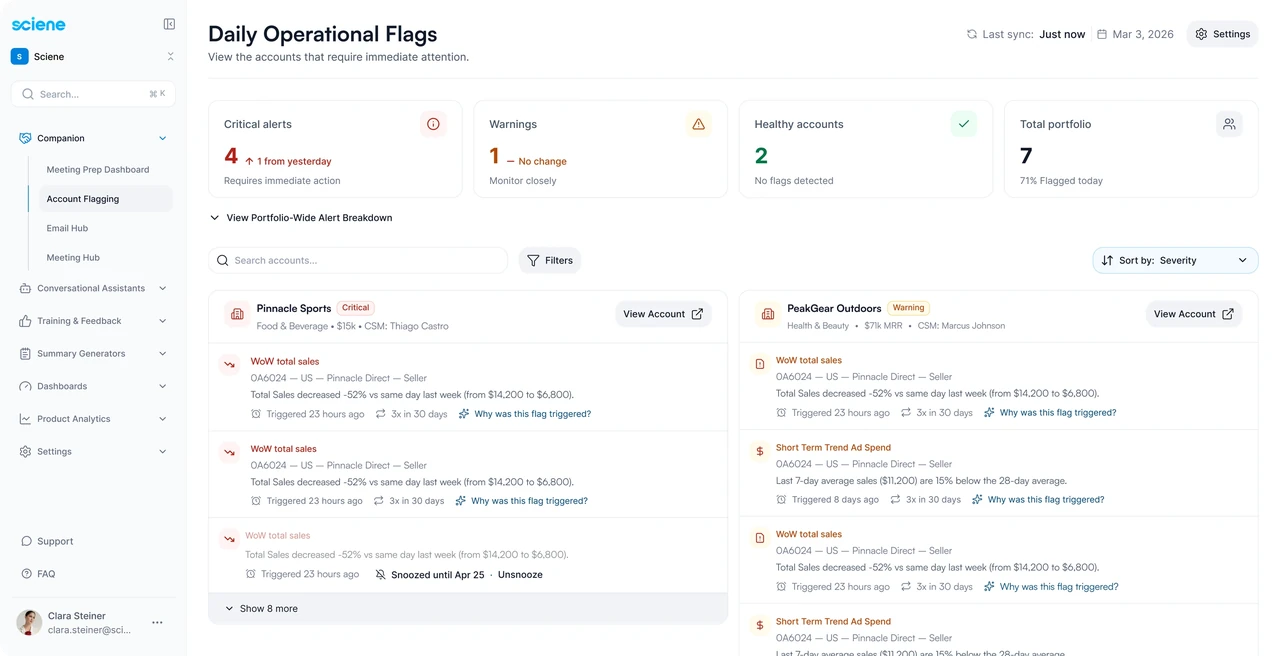
Os problemas só apareciam quando o cliente ligava
Nos clientes enterprise da Sciene, cada CSM cuida de 10 a 20 contas ou mais. Quedas nas vendas, picos de investimento em mídia, produtos suspensos e pagamentos atrasados costumavam vir à tona quando um cliente ligava, já irritado. Os times acompanhavam as contas em um dashboard externo, separado das outras ferramentas que usavam.
O Companion reúne o dia de trabalho do CSM em um só produto. A manhã começa pelo Account Flagging, antes do Email Hub e do Meeting Hub.
- Account FlaggingMostra as contas que precisam de atenção.
- Email HubAjuda o CSM a responder por escrito, com o contexto da conta.
- Meeting HubLeva os alertas abertos e as conversas para a preparação das reuniões.
Ao longo de seis semanas, entrevistei 3 diretores e 12 CSMs que atendiam contas de portes diferentes. Perguntei onde procuravam problemas, em quais dados confiavam e quando pediam ajuda. Antes de considerar uma conta em risco, eles cruzavam à mão o histórico, a atividade recente e as métricas de desempenho. Por isso, cada alerta precisava mostrar por que disparou e quais sinais estavam por trás dele: as mesmas checagens que os CSMs já faziam à mão.
Por que este alerta disparou?
Nos últimos 7 dias, o custo de publicidade sobre vendas (ACoS) desta conta subiu de 24% para 36%, acima da meta de 30%. O investimento em anúncios cresceu 22%, enquanto as vendas atribuídas caíram 18%, sinal de que as campanhas estão perdendo eficiência.
A primeira versão mostrava tudo, mas não dizia o que importava
Nossa primeira versão mostrava todos os alertas que o sistema conseguia gerar. Nos testes, os CSMs não davam conta de acompanhar. Os insights de IA geralmente acertavam, mas não ajudavam ninguém a decidir por onde começar.
Montei um artifact do Claude conectado ao Databricks para puxar os dados de reconhecimento de alertas da v0. Em uma semana, os números estavam claros: só 34% dos alertas eram reconhecidos em até 24 horas. O resto era ignorado, adiado indefinidamente ou ficava soterrado por alertas mais novos.
- ACoS acima da metaNorthwind OutdoorsACoS de 36% com meta de 30%, faixa habitual de 18–28%Por que este alerta disparou?
- Vendas caíram 32%Harbor & Pine HomeUS$ 9,4 mil contra US$ 13,8 mil na semana passada, limite de −20%Por que este alerta disparou?
- Anúncios suspensosBrightleaf Pantry4 anúncios fora do ar há 2 dias, limite de 24 horasPor que este alerta disparou?
3 alertas. 82% reconhecidos em até 24 horas.
Menos alertas, cada um com seu motivo
O time pensou em adicionar mais filtros. Eles entraram na v1, mas sozinhos só iam esconder o ruído. A maior parte do ruído vinha de limites que viam risco em oscilações normais de investimento e em outras variações parecidas. Então corrigimos os limites.
Revisei os limites um a um com os CSMs e seus diretores, e decidimos juntos quais alertas mereciam atenção. Os engenheiros de IA transformaram essas decisões em regras. Eu prototipava uma regra, eles testavam com dados de produção, e fomos ajustando até a taxa de falsos positivos ficar aceitável para os CSMs. O que sobrou foram riscos reais, e por isso eles passaram a receber atenção.
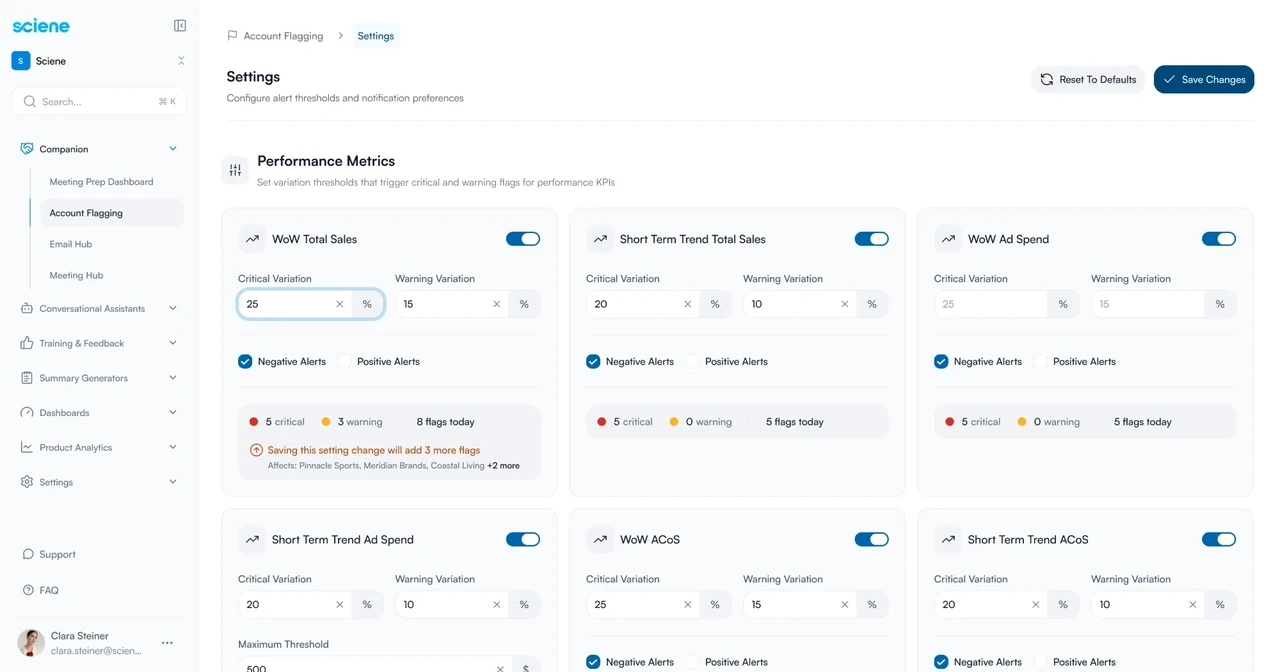
Variação para alerta crítico
A explicação da IA só carrega quando o CSM pede
Todo alerta já mostra seus números: o valor observado, o limite e a faixa histórica. O insight de IA acrescenta uma explicação por escrito. Gerar uma para cada alerta gastaria tokens com textos que ninguém leria, então só geramos a explicação quando o CSM abre o alerta.
Com isso, o custo virou uma espera, justo na hora em que a pessoa quer contexto. Os números continuam na tela, e um skeleton ocupa o espaço da explicação enquanto ela carrega, para o painel não pular quando o texto chegar.
ACoS acima da metaCrítico
Northwind Outdoors · EUA · Seller
ACoS de 36% com meta de 30%, faixa habitual de 18–28%
Os diretores veem os mesmos alertas, consolidados
Com a manhã dos CSMs organizada, os diretores precisavam de uma visão do time inteiro. O Director Dashboard mostra o MRR sob alerta de cada CSM, as taxas de resolução e um ranking de prioridade por carga de trabalho. Todos os números saem das mesmas regras que os CSMs veem.
Visão geral · Mês atual
Últimos 30 dias vs 30 dias anteriores
Alertas ativos por categoria
Distribuição entre todos os CSMs
CSMs · Ranking de prioridade
Ordenar por Número de alertas- Alertas no mês12 críticos · 6 de atenção18+8
- Taxa de resoluçãomédia de 1h para resolver56%−14 pts
- Sequência em alertaVitacup12d+5d
Este mês · por status
- Resolvidos10
- Adiados3
- Pediram ajuda5
Por categoria
- Desempenho10
- Financeiro5
- Negócio3
Tendência
| Período | Crítico | Atenção | Resolvidos | Adiados | Ajuda |
|---|---|---|---|---|---|
| Ontem | 2 | 1 | 1 | 1 | 1 |
| Últimos 7 dias | 6 | 3 | 5 | 1 | 3 |
| Este mês | 12 | 6 | 10 | 3 | 5 |
| Mês passado | 6 | 4 | 7 | 1 | 2 |
Os CSMs podem marcar uma conta como “ajuda solicitada”. O pedido aparece na tela do diretor, e o CSM vê quando o diretor confirma o recebimento.
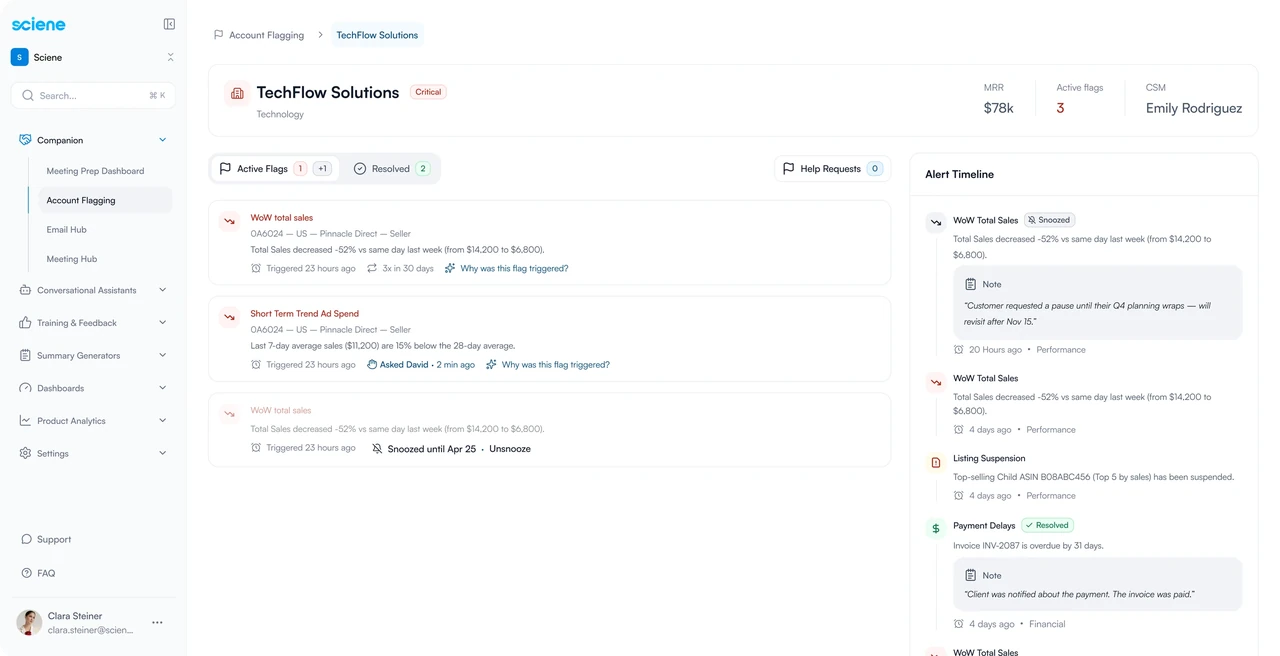
Os mesmos componentes de alerta nos três módulos
Construí o design system do zero, em paralelo à v1: tokens, biblioteca de componentes, padrões de acessibilidade e documentação de handoff. Estados de alerta, severidade e controles de reconhecimento viraram componentes compartilhados entre o Account Flagging, o Email Hub e o Meeting Hub, que também desenhei. O Director Dashboard da v2 foi montado inteiro com peças que já existiam.